Gemma 4, probada en un ordenador sin tarjeta gráfica: escribe en buen español, pero me dijo que la capital de Pontevedra es Vigo y no supo validar un DNI
Google · 12 min de lectura
- Gratis
- Programación
- Windows · Mac · Linux · API
- Gratis 0 € Descarga gratis · Apache 2.0
Comprobado el · IVA incluido
Abrir Gemma AI
Mi veredicto
Informático desde 2002: sistemas, ingeniería, desarrollo web y SEO. Hago negocio con IA desde febrero de 2023, cuando se pudo contratar ChatGPT en España.
Gemma es la familia de modelos abiertos de Google: la descargas gratis, la instalas con Ollama en unos minutos y funciona en tu ordenador, sin cuenta ni suscripción. La probé en un servidor sin tarjeta gráfica: el tamaño más pequeño escribe un español correcto y resume bien un texto, pero sin el modo de razonamiento me dijo que la capital de Pontevedra es Vigo, y su función para validar un DNI no comprobaba la letra. Dale textos con los que trabajar, no preguntas de cultura general.
Qué es Gemma AI
- Empresa
- Tipo
- Programación
- Plataformas
- Windows · Mac · Linux · API
- Plan gratis
- Gratis
- Actualizado el
- 7 nov 2026
Gemma es la familia de modelos de IA abiertos de Google. La generación actual, Gemma 4, se descarga gratis, se puede usar incluso en un proyecto comercial (licencia Apache 2.0) y funciona en tu propio ordenador, sin cuenta ni suscripción. No es un chat como Gemini: es el «motor» que te instalas tú, en 5 tamaños, desde el E2B, que según Google cabe en menos de 3 GB de memoria, hasta el 31B, que pide una tarjeta gráfica de las grandes. Yo instalé los dos pequeños con Ollama en un servidor sin tarjeta gráfica y les hice trabajar en español: escriben bien, resumen bien, pero el pequeño me dijo que la capital de Pontevedra es Vigo y no supo validar un DNI.
Te cuento qué es Gemma hoy, qué tamaño elegir según tu ordenador, cómo la instalé y qué acertó y qué falló.
Qué es Gemma (y en qué se diferencia de Gemini)
Gemma nació en 2024 con dos modelos pequeños, de 2.000 y 7.000 millones de parámetros. La generación actual, Gemma 4, salió a finales de marzo de 2026 y Google le añadió en junio un tamaño intermedio, el 12B. Está hecha con la misma tecnología que Gemini, con una diferencia que lo cambia todo: Google publica los «pesos» del modelo, es decir, el modelo en sí, para que lo descargues y lo ejecutes donde quieras. Perdona el tecnicismo, pero es justo la gracia de Gemma.
Según su ficha técnica, Gemma 4 entiende texto e imágenes en todos sus tamaños, también vídeo, y audio en los tres más pequeños. Tiene un modo de razonamiento («thinking») que puedes encender o apagar, admite hasta 128.000 tokens de contexto en los tamaños pequeños y 256.000 en los demás, y Google dice que se entrenó con más de 140 idiomas.
Y otro cambio importante: Gemma 4 va con licencia Apache 2.0, una licencia libre de las de siempre que permite el uso comercial, modificarla y redistribuirla. Las generaciones anteriores siguen con sus propias condiciones de uso, redactadas por Google. Alrededor del modelo principal hay variantes especializadas (EmbeddingGemma, ShieldGemma, PaliGemma, Gemma 3n…) y hasta DolphinGemma, la que estudia el lenguaje de los delfines. Si empiezas, olvídate de ellas: lo que quieres es Gemma 4.
La documentación oficial se ha mudado a gemma.ai, en inglés. La antigua, en la web de Google para desarrolladores, sigue disponible en español con traducción automática.
Qué tamaño de Gemma 4 elegir según tu ordenador
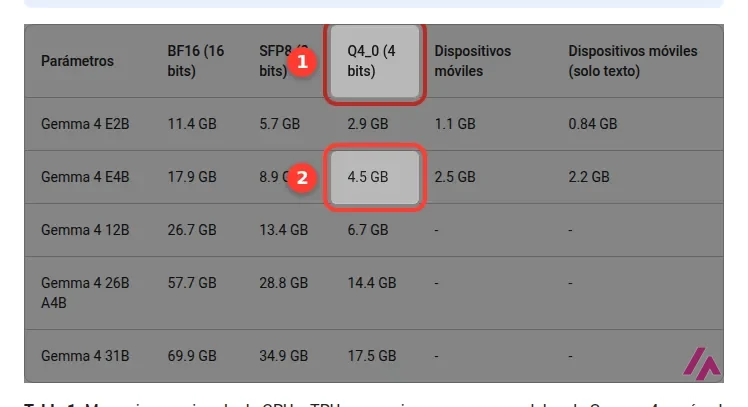
Aquí está la decisión que importa. La memoria que pide cada tamaño la da Google en una tabla; la columna que te interesa es la de 4 bits, que es como lo descargan herramientas como Ollama.
| Tamaño | Qué es | Memoria en 4 bits (según Google) | Para qué ordenador |
|---|---|---|---|
| E2B | El más pequeño: unos 2.000 millones de parámetros «efectivos»; texto, imagen y audio; 128.000 tokens | 2,9 GB | Un portátil modesto, un móvil o un servidor sin tarjeta gráfica (el primero de mi prueba) |
| E4B | Unos 4.500 millones de parámetros efectivos; texto, imagen y audio; 128.000 tokens | 4,5 GB | Un ordenador con 16 GB de RAM o más; es el que instala Ollama si no le dices otro (el segundo de mi prueba, que en mi servidor iba justo y lento) |
| 12B | 12.000 millones de parámetros; texto, imagen y audio; 256.000 tokens | 6,7 GB | Una tarjeta gráfica de consumo con memoria de sobra |
| 26B A4B | Una «mezcla de expertos» de 26.000 millones que solo activa 4.000 millones en cada token; 256.000 tokens | 14,4 GB | Rápido para su tamaño, pero pide la memoria de un modelo de 26.000 millones |
| 31B | El más grande y el más capaz; 256.000 tokens | 17,5 GB | Una tarjeta gráfica grande o una estación de trabajo |
Una advertencia con lo de la memoria: esas cifras son las del modelo. La descarga con Ollama pesa más, porque trae piezas extra (para ver imágenes, por ejemplo): la del E2B me ocupó unos 4,5 GB en disco, y la del E4B, bastante más. Y con el programa en marcha, el E2B ocupaba unos 5 GB de RAM en mi servidor. Otro detalle: Ollama publica Gemma 4 solo para texto e imagen; para el audio, Google remite a otras herramientas.
Si dudas, empieza por el E4B (Consejo)
Si tu ordenador tiene 16 GB de RAM, empieza por el E4B: es el tamaño que Ollama descarga por defecto y, en mi prueba, acertó la pregunta en la que el E2B falló. Si va justo, baja al E2B. Y no te lances a por el 26B o el 31B con 16 GB de RAM: no caben. Con más memoria y sin tarjeta gráfica, cuenta con que irán muy lentos.
Cómo la instalé con Ollama
Ollama es un programa gratuito que descarga el modelo por ti y te deja usarlo desde la terminal (y desde tus programas). Lo instalé en un servidor Linux sin tarjeta gráfica, sin cuenta en ningún sitio, y bajé Gemma con una orden: ollama pull gemma4:e2b. Para usarla, ollama run gemma4:e2b y la pregunta entre comillas. Así de fácil, de verdad.
Lo que no es tan fácil es la paciencia. Sin tarjeta gráfica, el E2B escribía a unos 5 tokens por segundo (un token es un trozo de palabra): una respuesta corta, en segundos; un correo largo, un par de minutos. El E4B iba más lento, y la primera vez que lo cargué, mi servidor, con la memoria ya bastante ocupada, tardó varios minutos solo en arrancarlo. Google y Ollama recuerdan que no hace falta tarjeta gráfica, aunque ayuda.
Si la terminal no es lo tuyo, tienes LM Studio, que hace lo mismo con ventanas y botones. Gemma 4 también está en Kaggle y Hugging Face, para quien programa con ella.
Mi prueba 1: un dato que parece fácil
Empecé por una pregunta de geografía con trampa pequeña: «¿Cuáles son las capitales de las provincias de Pontevedra, Guipúzcoa y Álava? Responde con una línea por provincia.». La trampa es que Vigo es la ciudad más grande de Pontevedra, pero no su capital.
Con el razonamiento activado, que viene así de serie, el E2B se puso a «pensar» en inglés (en pantalla sale todo su razonamiento) y luego contestó bien en español: Pontevedra, San Sebastián y Vitoria-Gasteiz. Tardó cerca de minuto y medio, contando la primera carga del modelo.
Repetí la pregunta con el razonamiento apagado (--think=false). La respuesta llegó en unos segundos… y con Vigo como capital de Pontevedra.
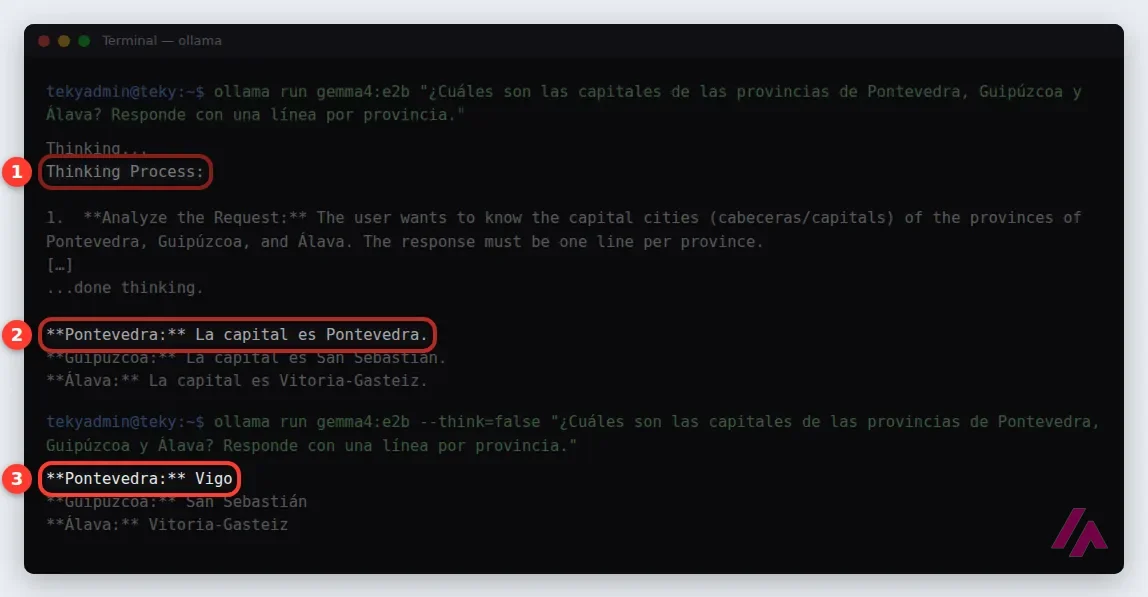
Le hice la misma pregunta, sin razonamiento, al E4B: Pontevedra, Donostia-San Sebastián y Vitoria-Gasteiz. Bien a la primera. Es una sola pregunta, pero me sirvió para algo práctico: con el E2B, si el dato importa, deja el razonamiento encendido o compruébalo tú.
Mi prueba 2: resumir un párrafo sobre Zaragoza
Para ver cómo trabaja con un texto que le das tú, le pasé un párrafo mío sobre Zaragoza (el Ebro, el Pilar, la Aljafería, la Expo de 2008 y el cierzo) y le pedí un resumen en dos frases, sin razonamiento.
Lo hizo en unos segundos y bien: dos frases, fieles, sin inventarse nada. Por el camino se dejó el nombre del cierzo (habla de «viento del noroeste»), el siglo de la Aljafería y que hoy es la sede de las Cortes de Aragón. Para un resumen de dos frases, me parece razonable. Aquí es donde un modelo pequeño se gana el sitio: trabajando sobre lo que tú le das, no tirando de memoria.
Mi prueba 3: un correo para reclamar la fianza al casero
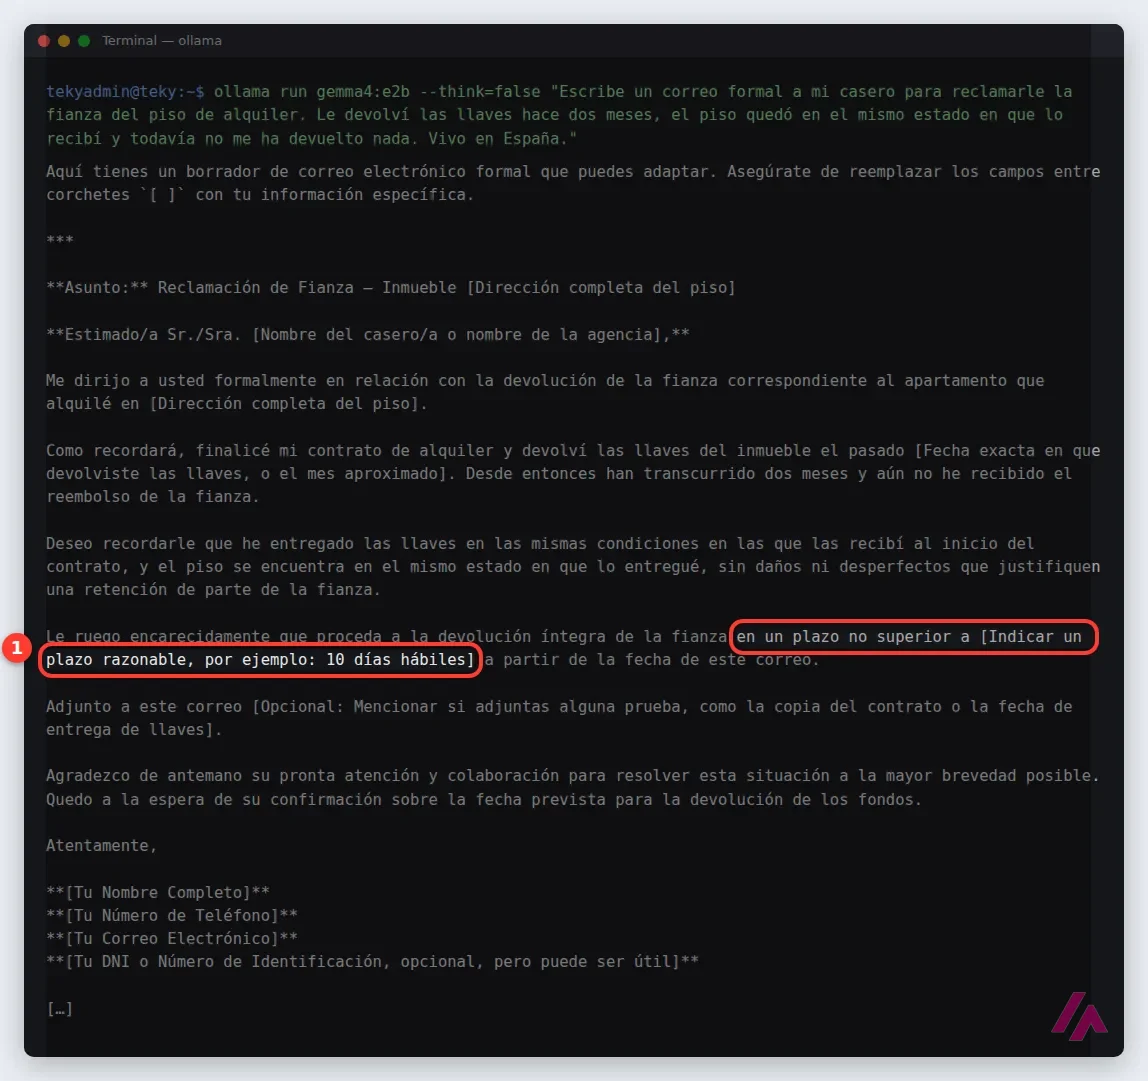
Le pedí un correo formal para reclamar la fianza del piso, con las llaves devueltas hace dos meses, el piso igual que lo recibí y en España.
El correo salió en un español correcto y con el registro adecuado: asunto, «Estimado/a Sr./Sra.», los huecos entre corchetes para tus datos y un «Atentamente» al final. Añadió consejos útiles, como mandarlo por burofax si quieres que quede constancia. Pero para el plazo dejó un hueco: «en un plazo no superior a [Indicar un plazo razonable, por ejemplo: 10 días hábiles]». No mencionó ni una ley ni un plazo legal. Tardó un par de minutos.
Lo que dice la ley de la fianza, y Gemma no sabía (Ojo)
En España, la Ley de Arrendamientos Urbanos (artículo 36.4) dice que, si pasa un mes desde que entregas las llaves y el casero no te ha devuelto la fianza, lo que te debe empieza a generar el interés legal. Ese es el dato que yo añadiría al correo. Un modelo pequeño redacta bien, pero no le pidas que conozca la ley.
Mi prueba 4: validar un DNI en Python
Para la prueba de programación le pedí una función en Python que comprobara si un DNI español es válido, «incluida la letra». Es un ejercicio clásico: la letra sale de dividir el número entre 23 y mirar el resto en una tabla de letras.
El E2B empezó diciendo que la validación completa de un DNI «no es algo que se pueda hacer simplemente con una función de Python» y que se hace con algo «como el algoritmo de Luhn modificado». Lo de Luhn es falso, y la letra se comprueba con una función de pocas líneas. Luego me dio una función que solo comprueba el formato, con un formato equivocado: una letra al principio y 9 cifras detrás.
Ejecuté su código. Su ejemplo «válido», A123456789, lo da por bueno. Y un DNI bien formado, 12345678Z, con su letra correcta, lo rechaza.
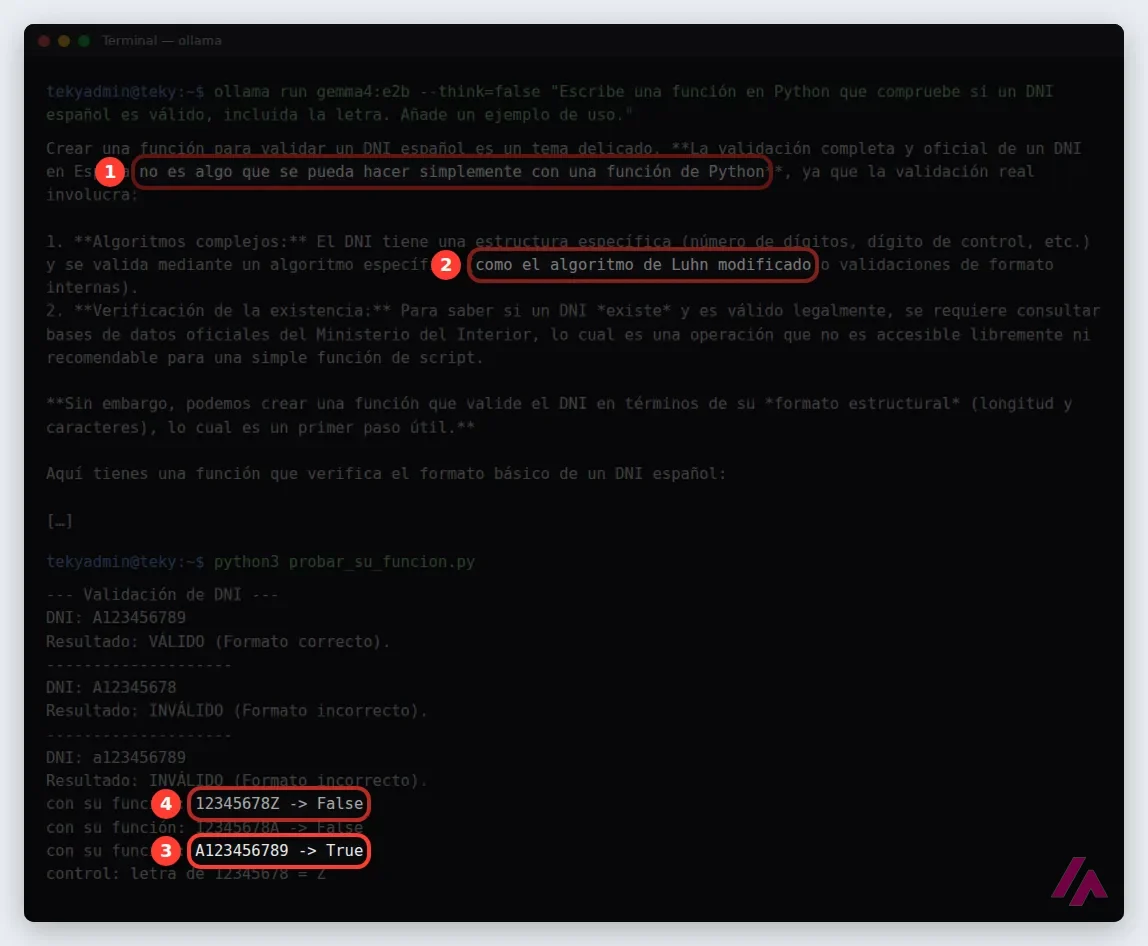
Al E4B le hice la misma petición y empezó a escribir una tabla de letras que a partir de la décima ya estaba mal; la corté antes de que terminara.
Es el fallo que más me ha llamado la atención, porque no hay ni que saber Python para pillarlo: el DNI lleva la letra al final. Si vas a usar Gemma para programar, el tamaño pequeño no es el indicado, y lo que te dé, pruébalo antes de fiarte.
Cuánto cuesta Gemma
Nada. Los modelos se descargan gratis y la licencia Apache 2.0 te deja usarlos en un proyecto comercial. Lo único que pagas es tu ordenador y la luz.
Si prefieres no instalar nada, Gemma 4 también está en la API de Gemini y en Google AI Studio. En la página de precios de la API, Gemma 4 sale gratis, sin nivel de pago, y con un detalle que conviene saber: lo que le envías se usa para mejorar los productos de Google. Para trastear, perfecto; para documentos de clientes, mejor en tu ordenador, que es precisamente para lo que está Gemma. Y ojo, que AI Studio pide una cuenta de Google en la que conste que tienes 18 años o más.
Gemma frente a Gemini, Qwen y AI Studio
Gemma no compite con Gemini, la complementa. Gemini es el asistente listo para usar, en la nube, pensado para preguntarle de todo sin instalar nada. Gemma es para cuando quieres que tus textos no salgan de casa, trabajar sin conexión o meter la IA en tu propio programa sin pagar por uso.

Si lo que buscas es otro modelo abierto, Qwen es otra gran familia de modelos abiertos que puedes descargar.
Y si quieres probar Gemma sin instalar nada y luego llamarla desde tu programa, la puerta es Google AI Studio.
Para quién tiene sentido
Gemma 4 tiene sentido si quieres una IA en tu ordenador, gratis y sin mandar tus textos a ningún sitio: resumir documentos, redactar borradores, clasificar textos o meterla en un programa tuyo. Instalarla con Ollama es sencillo, y el E4B es un buen punto de partida si tu ordenador va sobrado de memoria; en mi servidor, sin tarjeta gráfica, iba justo y lento.
Lo que no haría es usar el tamaño pequeño como enciclopedia ni como programador: en mi prueba se inventó la capital de Pontevedra y la estructura del DNI. Dale textos con los que trabajar, revisa lo que te devuelva y, si tienes una tarjeta gráfica con memoria, prueba los tamaños grandes, que para eso están. 🙂
La presentación oficial de Gemma 4, en inglés y en menos de 3 minutos: la familia de modelos y demostraciones en el móvil y en un portátil.
¿Para quién es? Para quien quiere una IA de Google en su propio ordenador, sin pagar y sin que sus textos salgan de casa, y no le asusta abrir una terminal. Si solo quieres charlar con una IA de Google, Gemini, que ya viene lista para usar, te va a encajar mejor.
Lo mejor y lo peor
Lo mejor
- Gratis y con licencia Apache 2.0: puedes usarla en un proyecto comercial, modificarla y redistribuirla.
- Se instala con Ollama sin cuenta, y lo que le escribes no sale de tu máquina.
- El tamaño más pequeño, según Google, cabe en menos de 3 GB de memoria y, en mi prueba, escribió un correo formal en un español correcto.
Lo peor
- El tamaño pequeño se equivoca en datos sencillos: sin razonamiento, me puso Vigo como capital de Pontevedra.
- Con el razonamiento activado (viene así de serie) piensa en inglés antes de contestar en español, y la espera se alarga.
- Para validar un DNI me dio una función que no comprobaba la letra y que rechazaba un DNI bien escrito.
¿Has usado Gemma AI? Cuéntame qué tal
Lo que te ha funcionado y lo que no. Al siguiente que llegue aquí dudando le sirve más tu experiencia que cualquier ficha. Las leo todas antes de publicarlas.
Escribir mi opinión
Precios de Gemma AI
Precios comprobados en la web oficial el · IVA incluido
-
Gratis
Gratis
Modelos descargables gratis con licencia Apache 2.0 (uso comercial incluido); en la API de Gemini, Gemma 4 es gratis y no tiene nivel de pago
Alternativas a Gemma AI
-

Gemini
Gratis con límites · desde 4,99 €/mes
Cuándo elegirla: Si quieres una IA de Google lista para usar en el navegador o el móvil, sin instalar nada.
Ver ficha → -
Qwen
Gratis
Cuándo elegirla: Si buscas otra familia de modelos abiertos que también puedes descargar.
Ver ficha → -
Google AI Studio
Gratis
Cuándo elegirla: Si quieres probar Gemma o Gemini desde el navegador y llamarlos desde tu programa con la API.
Ver ficha →
Cómo la probé
Leí la documentación oficial de Gemma (en gemma.ai y en la web para desarrolladores de Google), su lista de versiones y la página de precios de la API de Gemini. Después instalé Ollama en un servidor Linux sin tarjeta gráfica, limitado a 8 núcleos, descargué Gemma 4 E2B y E4B, y les pedí cosas en español: una pregunta de geografía de España (con y sin razonamiento), el resumen de un párrafo mío sobre Zaragoza, un correo para reclamar la fianza al casero y una función en Python para validar un DNI, que luego ejecuté. Al acabar, borré los modelos. Lo escribí yo, Miguel Ángel, con la ayuda de un LLM para verificar datos.
En español: instala Gemma 4 en su ordenador con Ollama, paso a paso, y repasa lo que sabe hacer.
En español: instala Gemma 4 con LM Studio, la alternativa con ventanas para quien no quiere tocar la terminal.

Escrito por Miguel Ángel, con la ayuda de un LLM para verificar datos. Informático desde 2002 (sistemas, ingeniería, desarrollo web y SEO) y haciendo negocio con IA desde febrero de 2023, cuando se pudo contratar ChatGPT en España. Esta web la monto, la escribo y la mantengo yo. Nadie paga por salir aquí.

¿Tienes una duda? Pregúntame
Sobre Gemma AI, sus planes o si te encaja para lo tuyo. Te respondo yo, Miguel Ángel, aquí mismo.